语音包变声器 正式版相关简介:
语音包变声器是一款基于数字音频处理与AI声纹模拟技术的实时变声工具,能够将用户原始声音即时转换为不同风格、性别或角色的声线。软件内置丰富的预设语音包,涵盖卡通、机器人、明星音色等多种类型,同时支持用户自定义调节音调、语速、共振峰等参数,实现从趣味娱乐到专业配音的多样化需求,广泛适用于直播互动、游戏社交、短视频创作及隐私保护等场景。
1. 实时变声处理:采用低延迟音频算法,实现毫秒级声音转换,确保直播连麦或游戏开黑时声画同步。
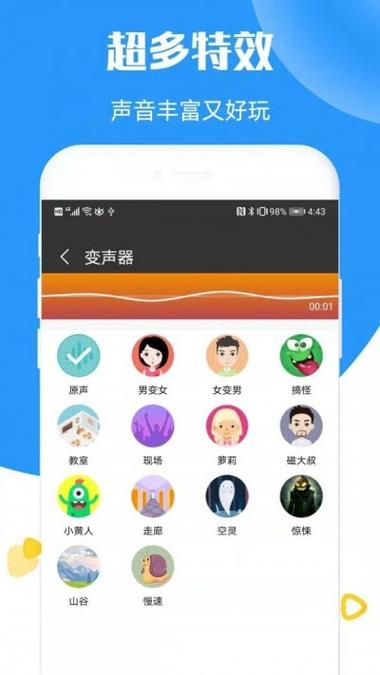
2. 海量预设语音库:内置数百种风格化音色模板,覆盖卡通、怪物、明星仿音等热门分类,一键切换即可获得专业级变声效果。
3. AI情感语调适配:高级模式支持语义分析,自动匹配笑声、叹息等情感细节,让合成声音摆脱机械感,更接近真人表达。
4. 多平台兼容:支持Windows、macOS、iOS及Android系统,同时兼容主流直播软件与游戏语音平台,无需复杂设置即可调用。
5. 智能降噪优化:内置环境噪声抑制算法,在嘈杂场景下也能保持变声清晰度,提升语音输出的整体质量。
1. 下载安装:访问官方网站或应用商店,下载对应设备版本的安装包,按提示完成安装并授予麦克风权限。
2. 选择输入输出设备:进入设置界面,将输入设备设为麦克风,输出设备设为需要使用的直播软件或通讯工具的虚拟音频通道。
3. 挑选语音包:浏览预设音色库,通过试听功能选择喜欢的声线风格,或进入自定义模式手动调节音调、共振峰等参数。
4. 实时测试调整:在测试窗口说话,观察波形变化与延迟情况,微调降噪强度与混响效果直至满意。
5. 应用至目标场景:确认设置后,在直播软件或游戏语音设置中选择该变声器作为音频输入源,即可开始实时变声互动。
2024.05.20 v3.2.0:新增AI情感引擎2.0版本,支持中英文混合语义识别,变声自然度提升40%;新增12款明星仿声音色包;优化移动端功耗,续航延长25%。
2024.03.15 v3.1.0:增加自定义声纹训练功能,用户可上传3分钟样本生成专属音色;修复Windows 11系统下部分声卡兼容问题;界面UI全面改版,操作路径缩短。
2024.01.10 v3.0.0:重构底层音频处理架构,延迟降低至30ms以内;支持实时多人语音包切换;新增游戏场景专属低延迟模式。